基于 K1 AI CPU 大模型部署落地
1. 简介
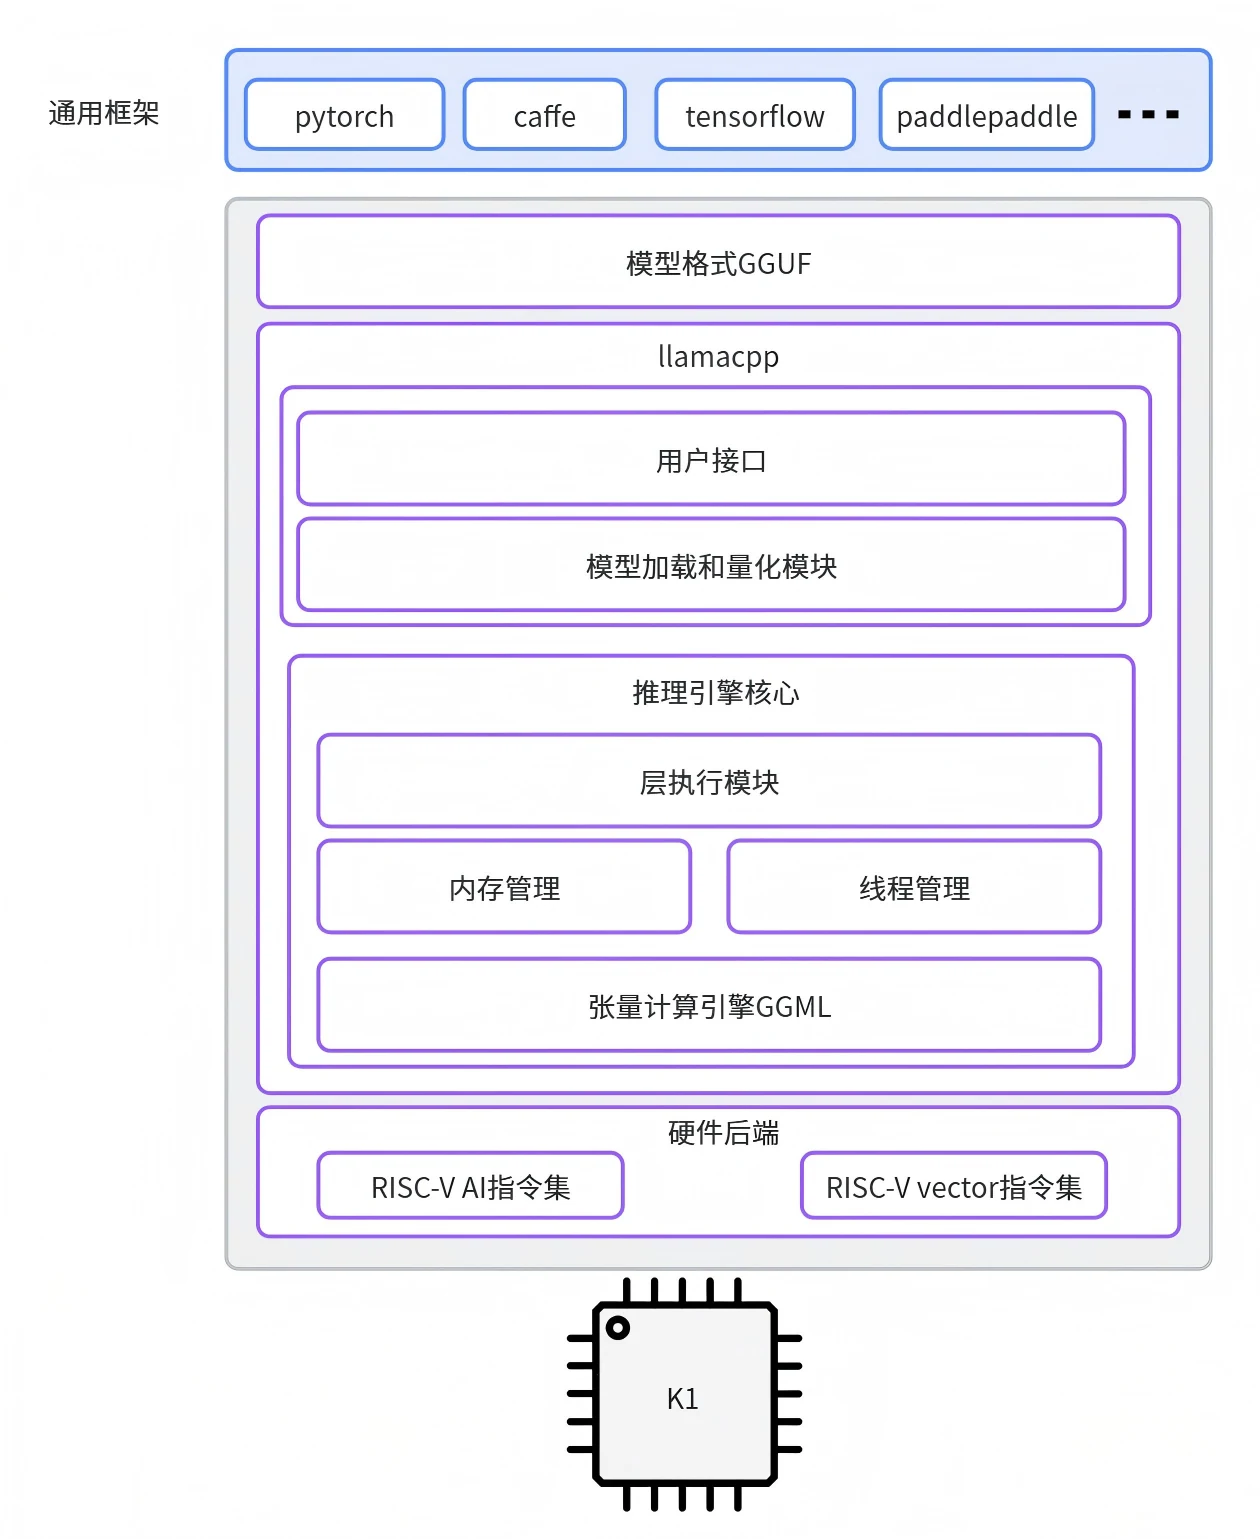
本赛题要求基于进迭开源的 Llama.cpp 进行部署。本工程在此基础上,额外增加了对进迭时空 AI 扩展指令的支持,并针对 K1 芯片进行了多项优化。优化主要集中在张量计算引擎 GGML,其余均保持与 Llama.cpp 源码一致。
整体架构如下图所示。
2. 编译使用
2.1 交叉编译
从进迭时空代码仓库拉取代码,切换到进迭时空开发分支,并使用脚本编译即可。详细编译流程如下:
# clone 代码
git clone git@github.com:ggml-org/llama.cpp.git

# 编译
参考docs/build-riscv64-spacemit.md,进行工程编译
编译完以后,工具和库会被安装到build/installed。其结构如下:

2.2 关键工具介绍
| 功能 | 名字 |
|---|---|
| 量化工具 | llama-quantize |
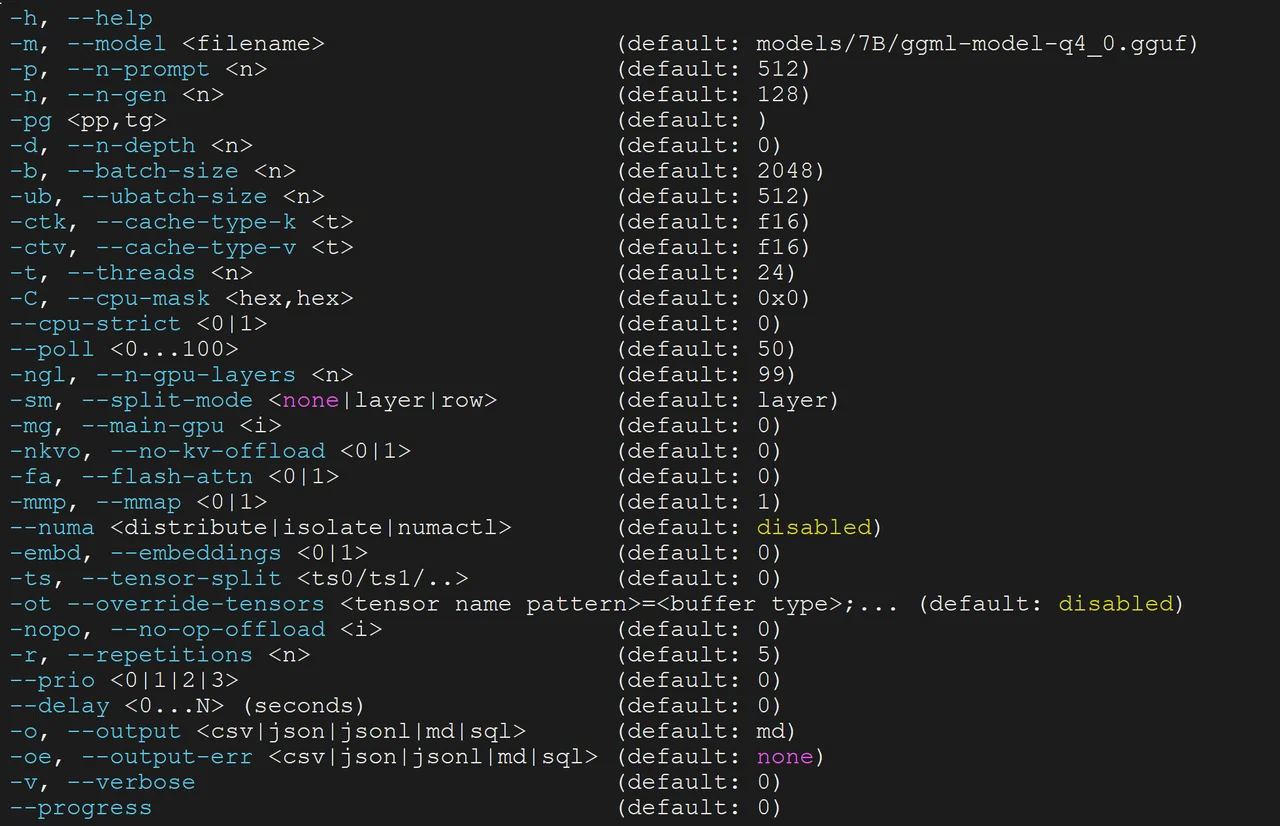
| benchmark工具 | llama-bench |
量化工具使用说明:
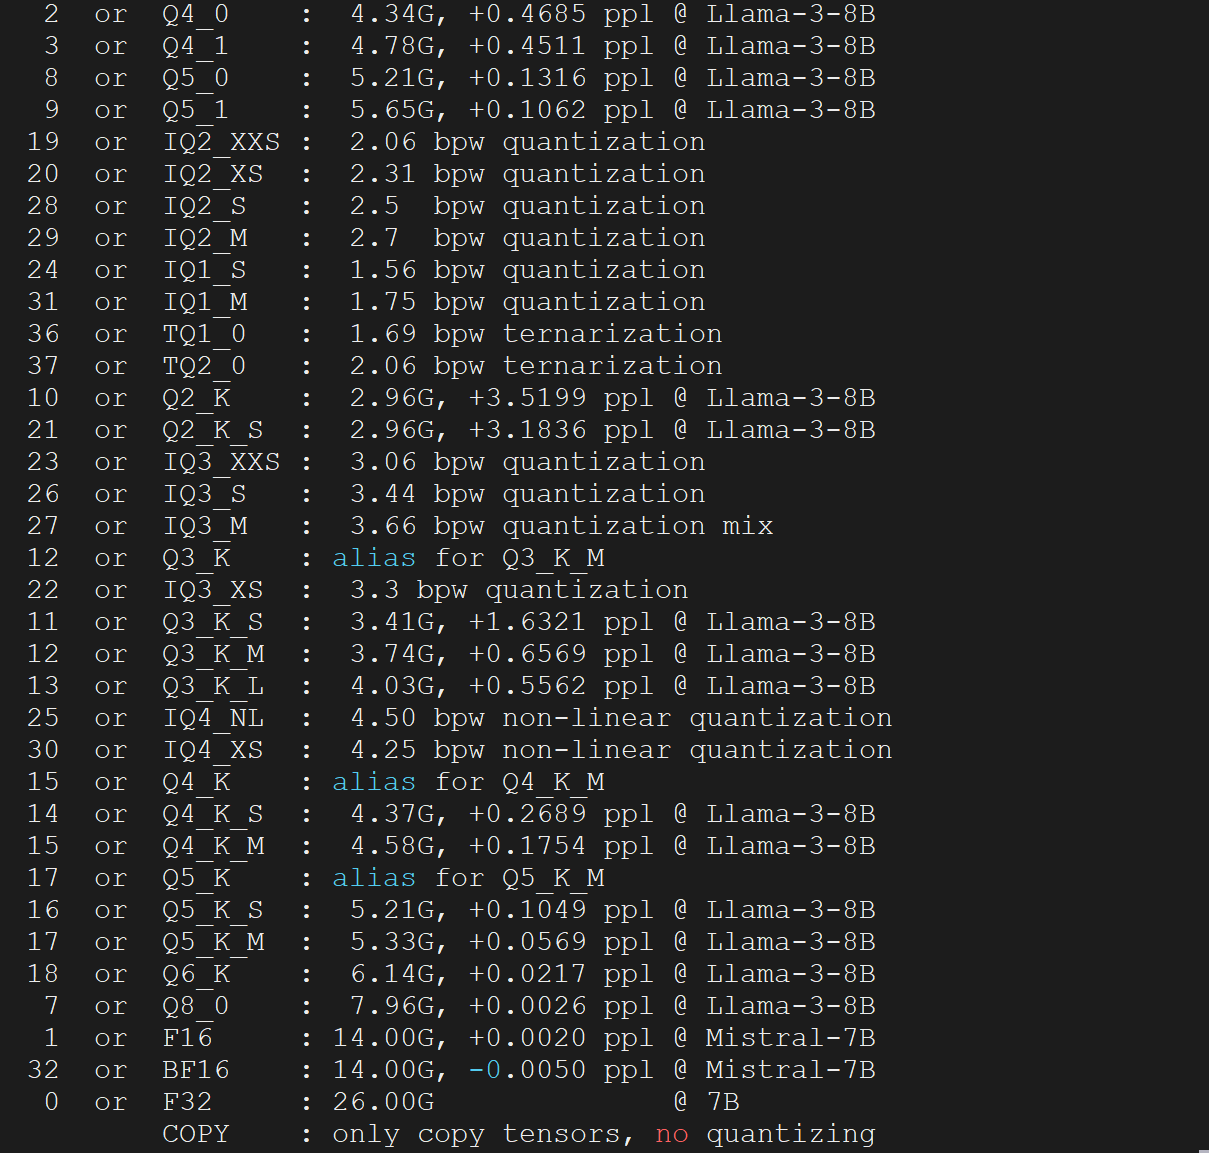
量化支持类型: